我国高血压患者已突破3亿,但血压控制率长期徘徊在16%左右。临床上一个普遍困境是:同样的降压方案,有人两周达标,有人换了三种药仍不理想。问题往往不在于药物本身,而在于个体间的药物代谢能力与靶点敏感性存在显著遗传差异。个体化用药基因检测正是试图在用药之前回答"这个患者适合哪类药、起始剂量怎么定"。
被忽视的变量:药物反应的遗传基础
降压药物的代谢涉及CYP2D6、CYP2C9、CYP3A4/5等肝药酶系统,而药物靶点如ACE、AGTR1、ADRB1等基因的多态性,直接影响药物与受体的结合效率。以美托洛尔为例,CYP2D6慢代谢型患者服用常规剂量后血药浓度可高出数倍,容易出现心动过缓;而CYP2C9*3携带者使用氯沙坦时,活性代谢产物生成减少,降压效果可能打折扣。这些差异写在基因里,靠试错调整往往要耗费数月。
传统"阶梯式试药"模式的隐性成本很高——血压未达标期间的靶器官损害持续累积,患者依从性也在反复换药中被消磨。高血压基因检测的价值在于把这段试错周期前置压缩,让初始处方更接近最优解。
从检测到管理:技术如何落到日常
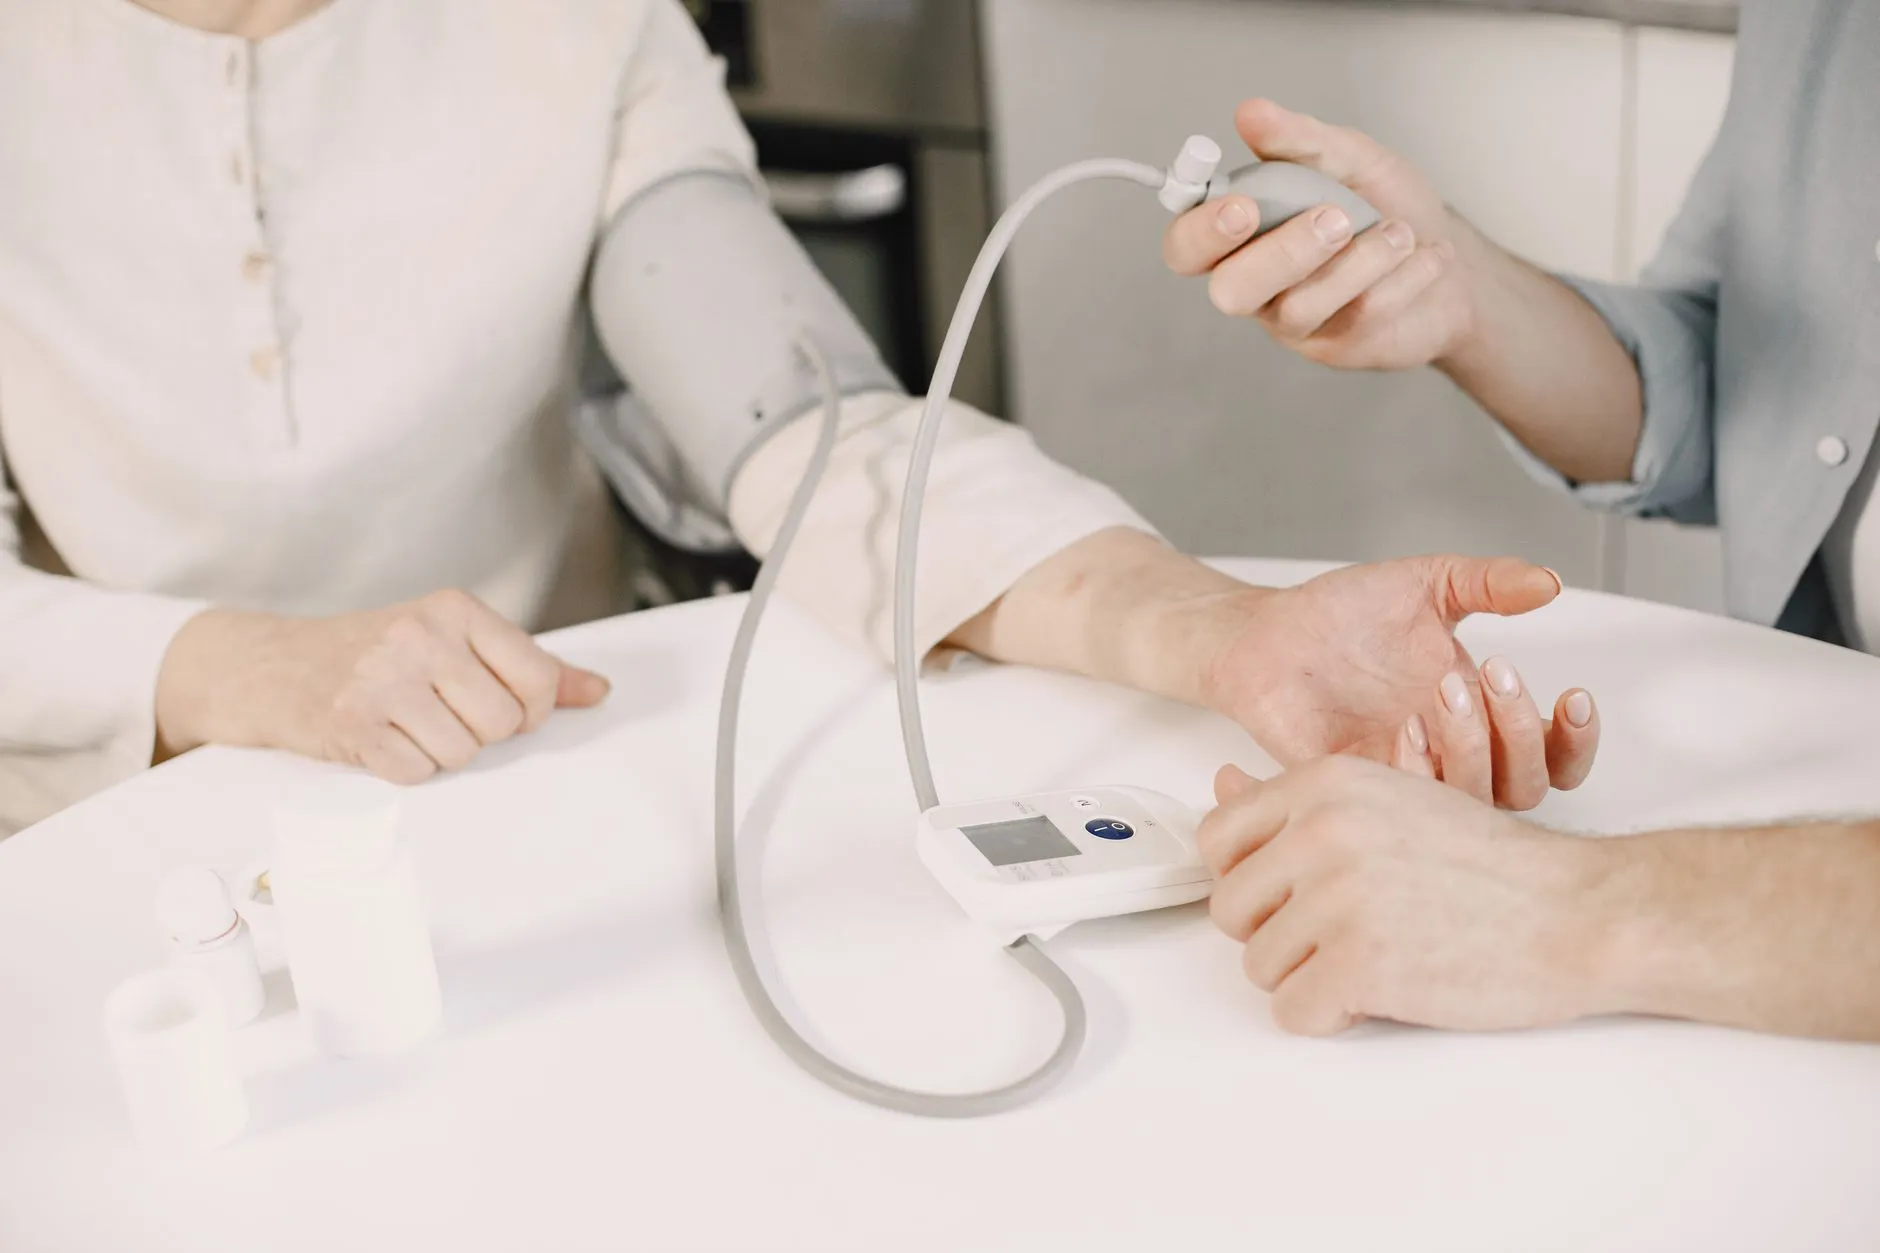
基因检测只是起点。真正决定慢病管理质量的是检测结果能否与动态血压数据形成闭环。千山健康的实践路径是将个体化用药基因检测报告与智能血压监测设备打通:检测端输出药物代谢分型与用药建议,监测端以家庭晨峰血压、夜间血压等参数持续回传,二者在管理平台上交叉验证用药方案的實際效果。
具体落地可参考以下流程:
- 基线评估:完成药物代谢基因位点检测,明确快/中/慢代谢分型及靶点敏感性
- 方案制定:结合基因分型、合并症与血压分级,由医生确定药物种类与起始剂量
- 动态校准:通过智能血压监测设备采集7–14天家庭血压谱,评估达标情况
- 迭代优化:血压未达标且排除依从性因素后,优先参照基因报告调整剂量或换药
这套流程的关键在于把基因信息从"一次性报告"变成"持续决策依据"。慢病精准管理的本质不是一次检测,而是检测数据、监测数据与临床判断之间的持续反馈。
应用前景与现实边界
需要客观看待的是,基因检测目前主要覆盖药物代谢酶与已知靶点,对盐敏感性、交感神经活性等复杂表型的预测能力仍有限。它不能替代生活方式干预,也无法覆盖所有降压药物的个体差异。但在难治性高血压、多药联用、反复出现不良反应等场景中,检测的临床价值已经较为明确。
随着药物基因组学证据库的扩充和可穿戴智能血压监测精度的提升,检测—监测—干预的闭环有望进一步缩短响应周期。对慢病管理机构而言,谁能把基因层面的个体差异转化为可执行的日常管理动作,谁就更接近真正的精准管理。